Raid 故障排查.note
·修复完 RAID 阵列后,建议都将 UUID 重新写入 /etc/mdadm/mdadm.conf(如果UUID一致就算了),然后update-initramfs -u 更新一下
1、排查思路、排查命令:
# 思路:
先看阵列状态 → 再看成员磁盘 → 再看 superblock → 再组装阵列 → 最后看文件系统和挂载
# 命令:
cat /proc/mdstat //看当前 RAID 是否存在、是否 degraded、是否 rebuilding
mdadm -D /dev/md0 //查看阵列详细状态
lsblk -f //看磁盘、分区、文件系统、挂载点
# 看每块磁盘上有没有 RAID superblock,属于哪个阵列
mdadm -E /dev/sdb1
mdadm -E /dev/sdc1
mdadm -E /dev/sdd1
# 查看日志:
journalctl -xe
dmesg | grep -Ei 'md|raid|sd[a-z]|error|fail'
# 查看系统日志:
cat /etc/mdadm/mdadm.conf# 对比配置文件中的 UUID 是否一致:
## 如果不一致,会导致mdadm启动后变成 /dev/md127
mdadm -D /dev/md0
cat /etc/mdadm/mdadm.conf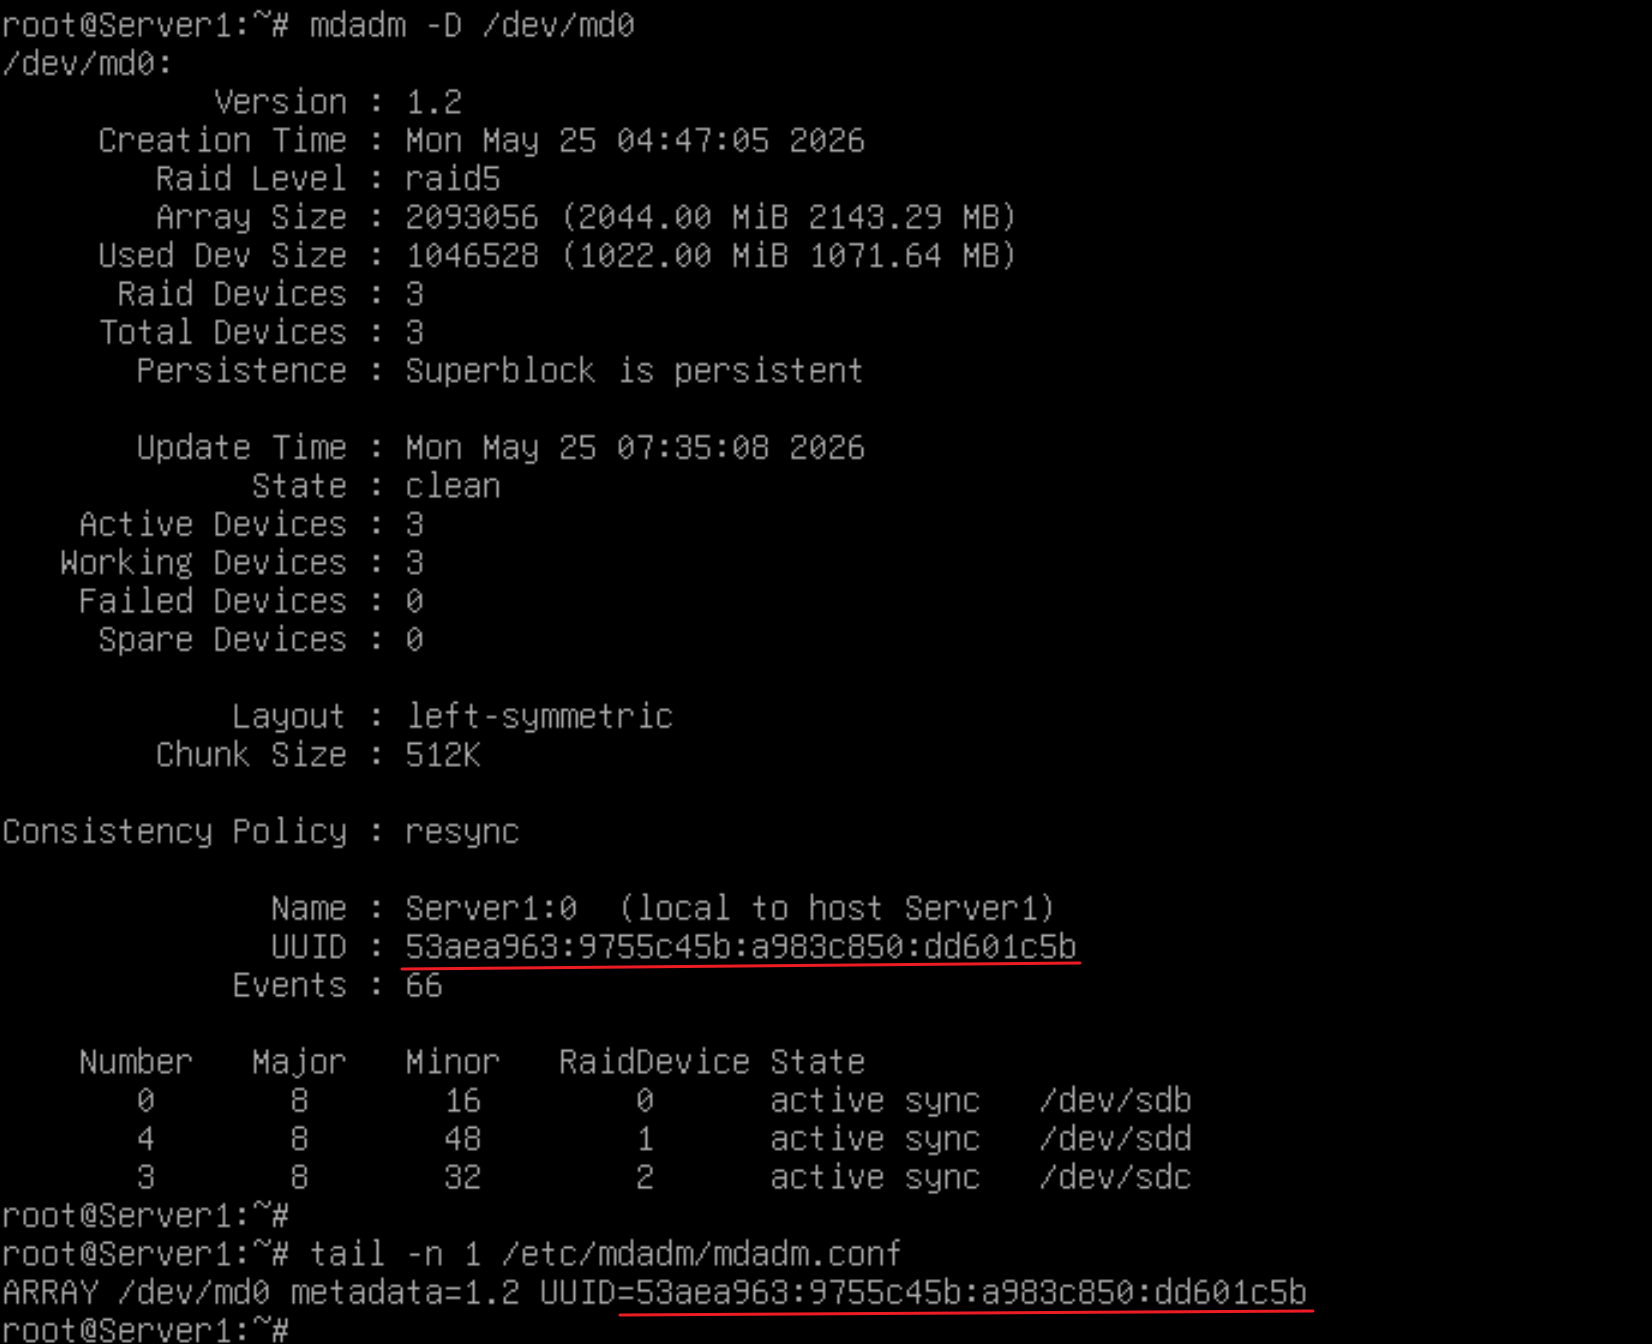
·先创建好 RAID 阵列:
# 创建RAID 5阵列:
mdadm -C /dev/md0 -l5 -n3 /dev/sd[bcd]
mdadm -Ds >> /etc/mdadm/mdadm.conf
udpate-initramfs -u
mkfs.ext4 /dev/md0
挂载磁盘:
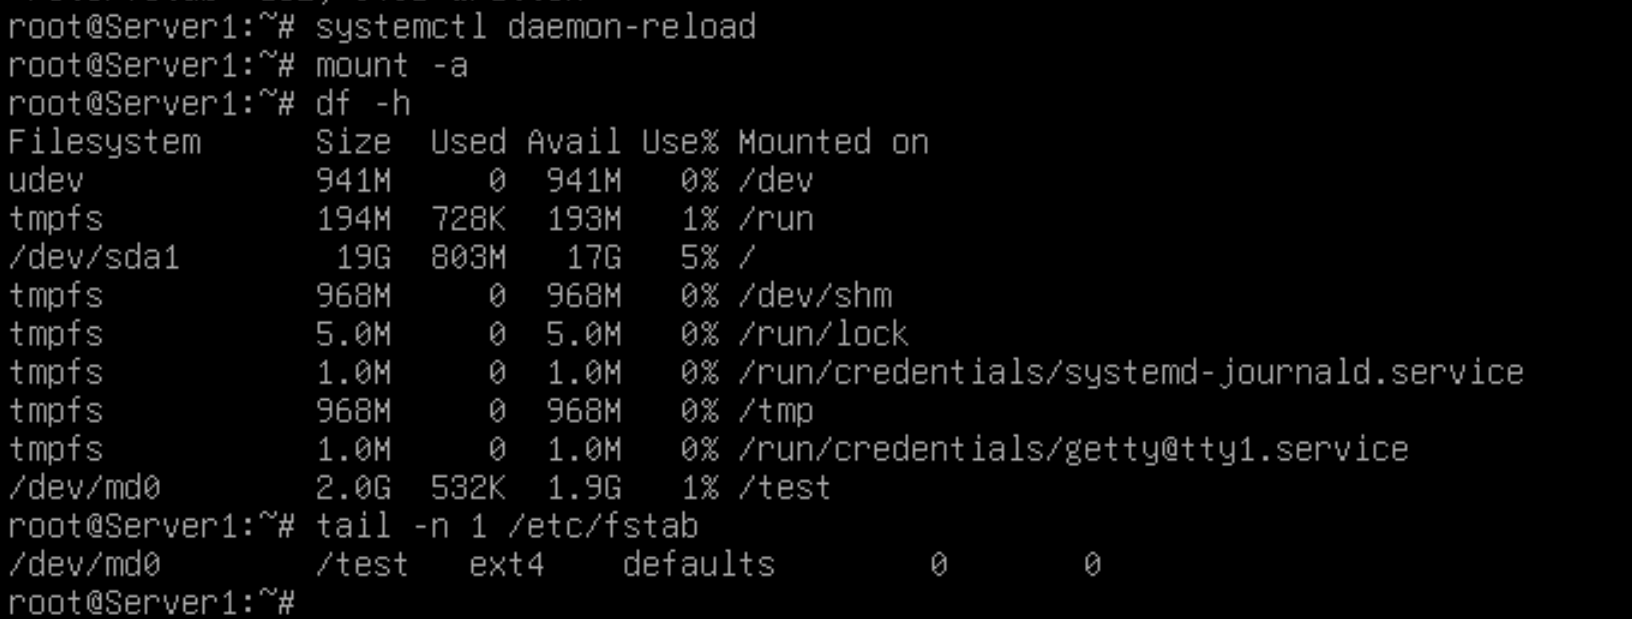
2、故障环境1(成员盘被手动设置为故障):
该故障点,重启机器后,这块磁盘就会被直接冲阵列中移除,状态变成 removed
·设置故障点:
# 设置故障:
mdadm /dev/md0 --fail /dev/sdc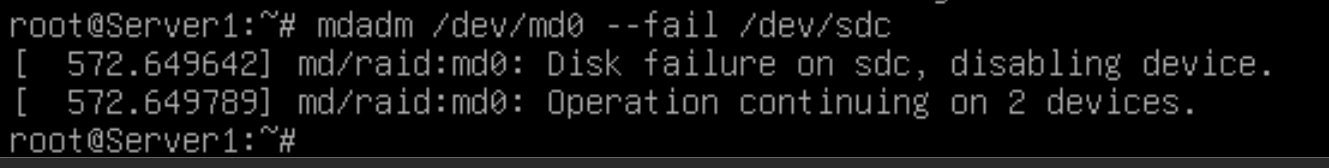
·症状:
mdadm -D /dev/md0 查看时,有一块磁盘状态为 faulty
该故障点,重启机器后,这块磁盘就会被直接冲阵列中移除,状态变成 removed
·进行排查:
mdadm -D /dev/md0
# 使用命令查看到/dev/md0阵列中的 /dev/sdc 磁盘是故障的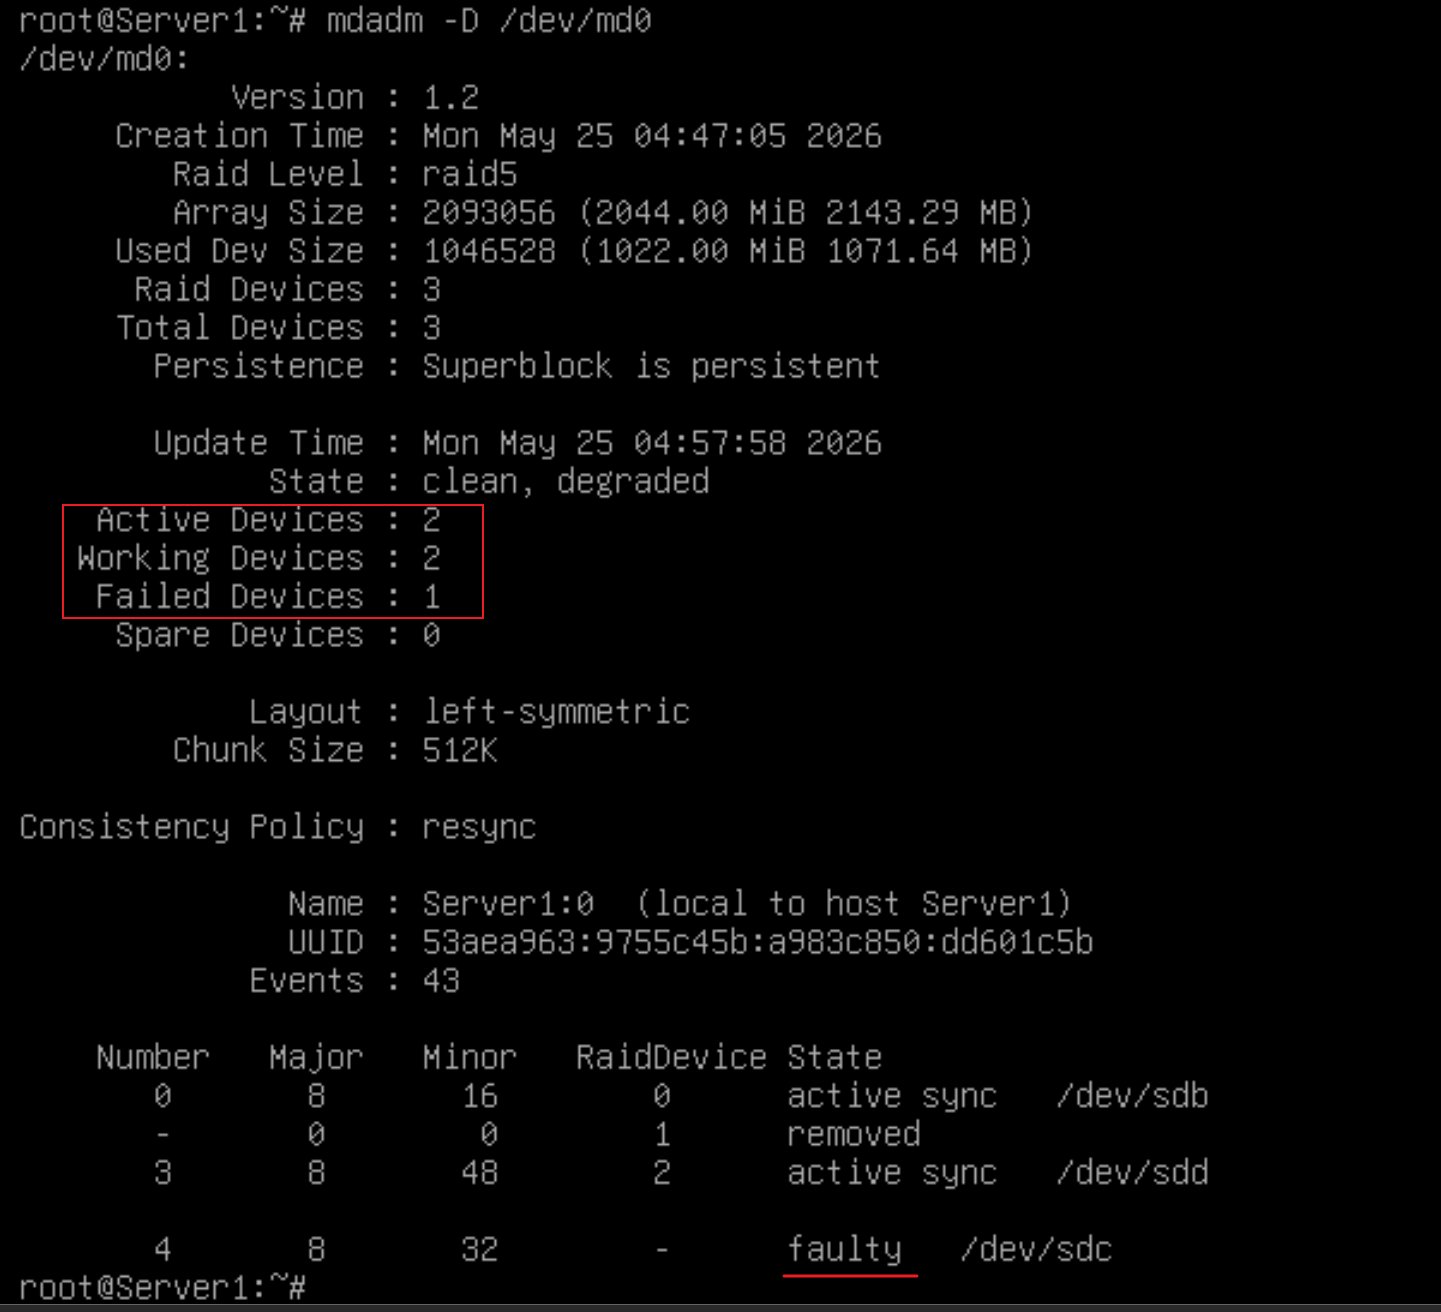
# 这里的状态:
faulty    //成员盘被标记为故障
removed    //表示缺一块盘
查看 RAID总状态:
cat /proc/mdstat
## U_U 表示三块盘有一块损坏
## 如果是 UUU 就表示正常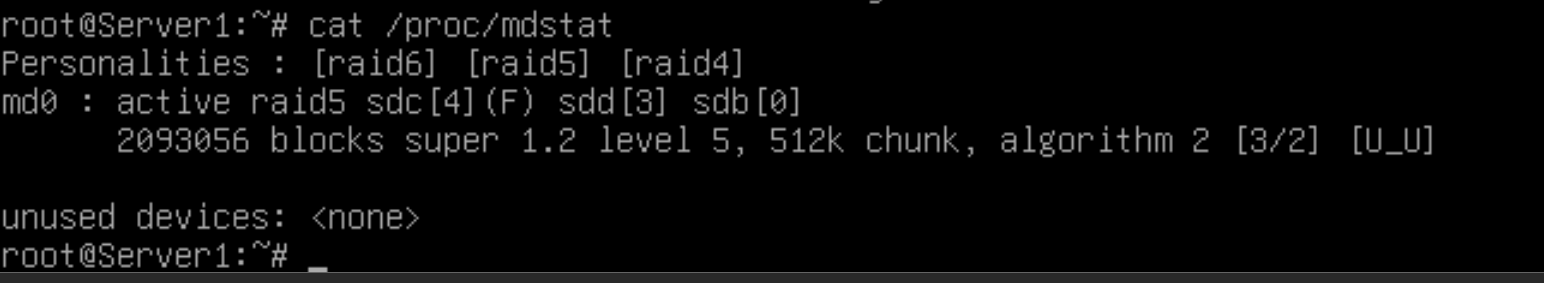
# 解决:
## 磁盘被误标记为 faulty:
mdadm /dev/md0 --remove /dev/sdc    //将这块磁盘移出 RAID 阵列
mdadm /dev/md0 --add /dev/sdc    //将这块磁盘添加进 RAID 阵列
·编写 ticket:
# 排查过程:
On Server1:
Execute the following command in the command line:
mdadm -D /dev/md0
find the /dev/sdc disk is marked as faulty in array /dev/md0.

# 问题:
On Server1:
the /dev/sdc disk is marked as faulty in array /dev/md0.

# 解决方法:
On Server1:
Execute the following command in the command line:
mdadm /dev/md0 --remove /dev/sdc
mdadm /dev/md0 --add /dev/sdc
mdadm -Ds >> /etc/mdadm/mdadm.conf
update-initramfs -u
and reboot Server device
3、故障环境2(RAID阵列 和 写在 /etc/mdadm/mdadm.conf文件中的UUID不一样,或者该文件中 没写UUID):
·设置故障点:
vim /etc/mdadm/mdadm.conf将mdadm 的 UUID删除,或者删掉一些字段
·症状:
1、如果 UUID 不一致(机器无法识别该UUID),启动时就会直接报错,进入磁盘报错的页面,需要输入密码才能直接登陆
2、如果 UUID 这行直接被删除,那么mdadm 阵列名称就会变为 /dev/md127 或者 raid阵列就没有随着重启启动
·进行排查:
# 查看 mdadm阵列状态:可以看到这里原来名字是叫做md0的,因此我们就需要将它的UUID写进 /etc/mdadm/mdadm.conf 中
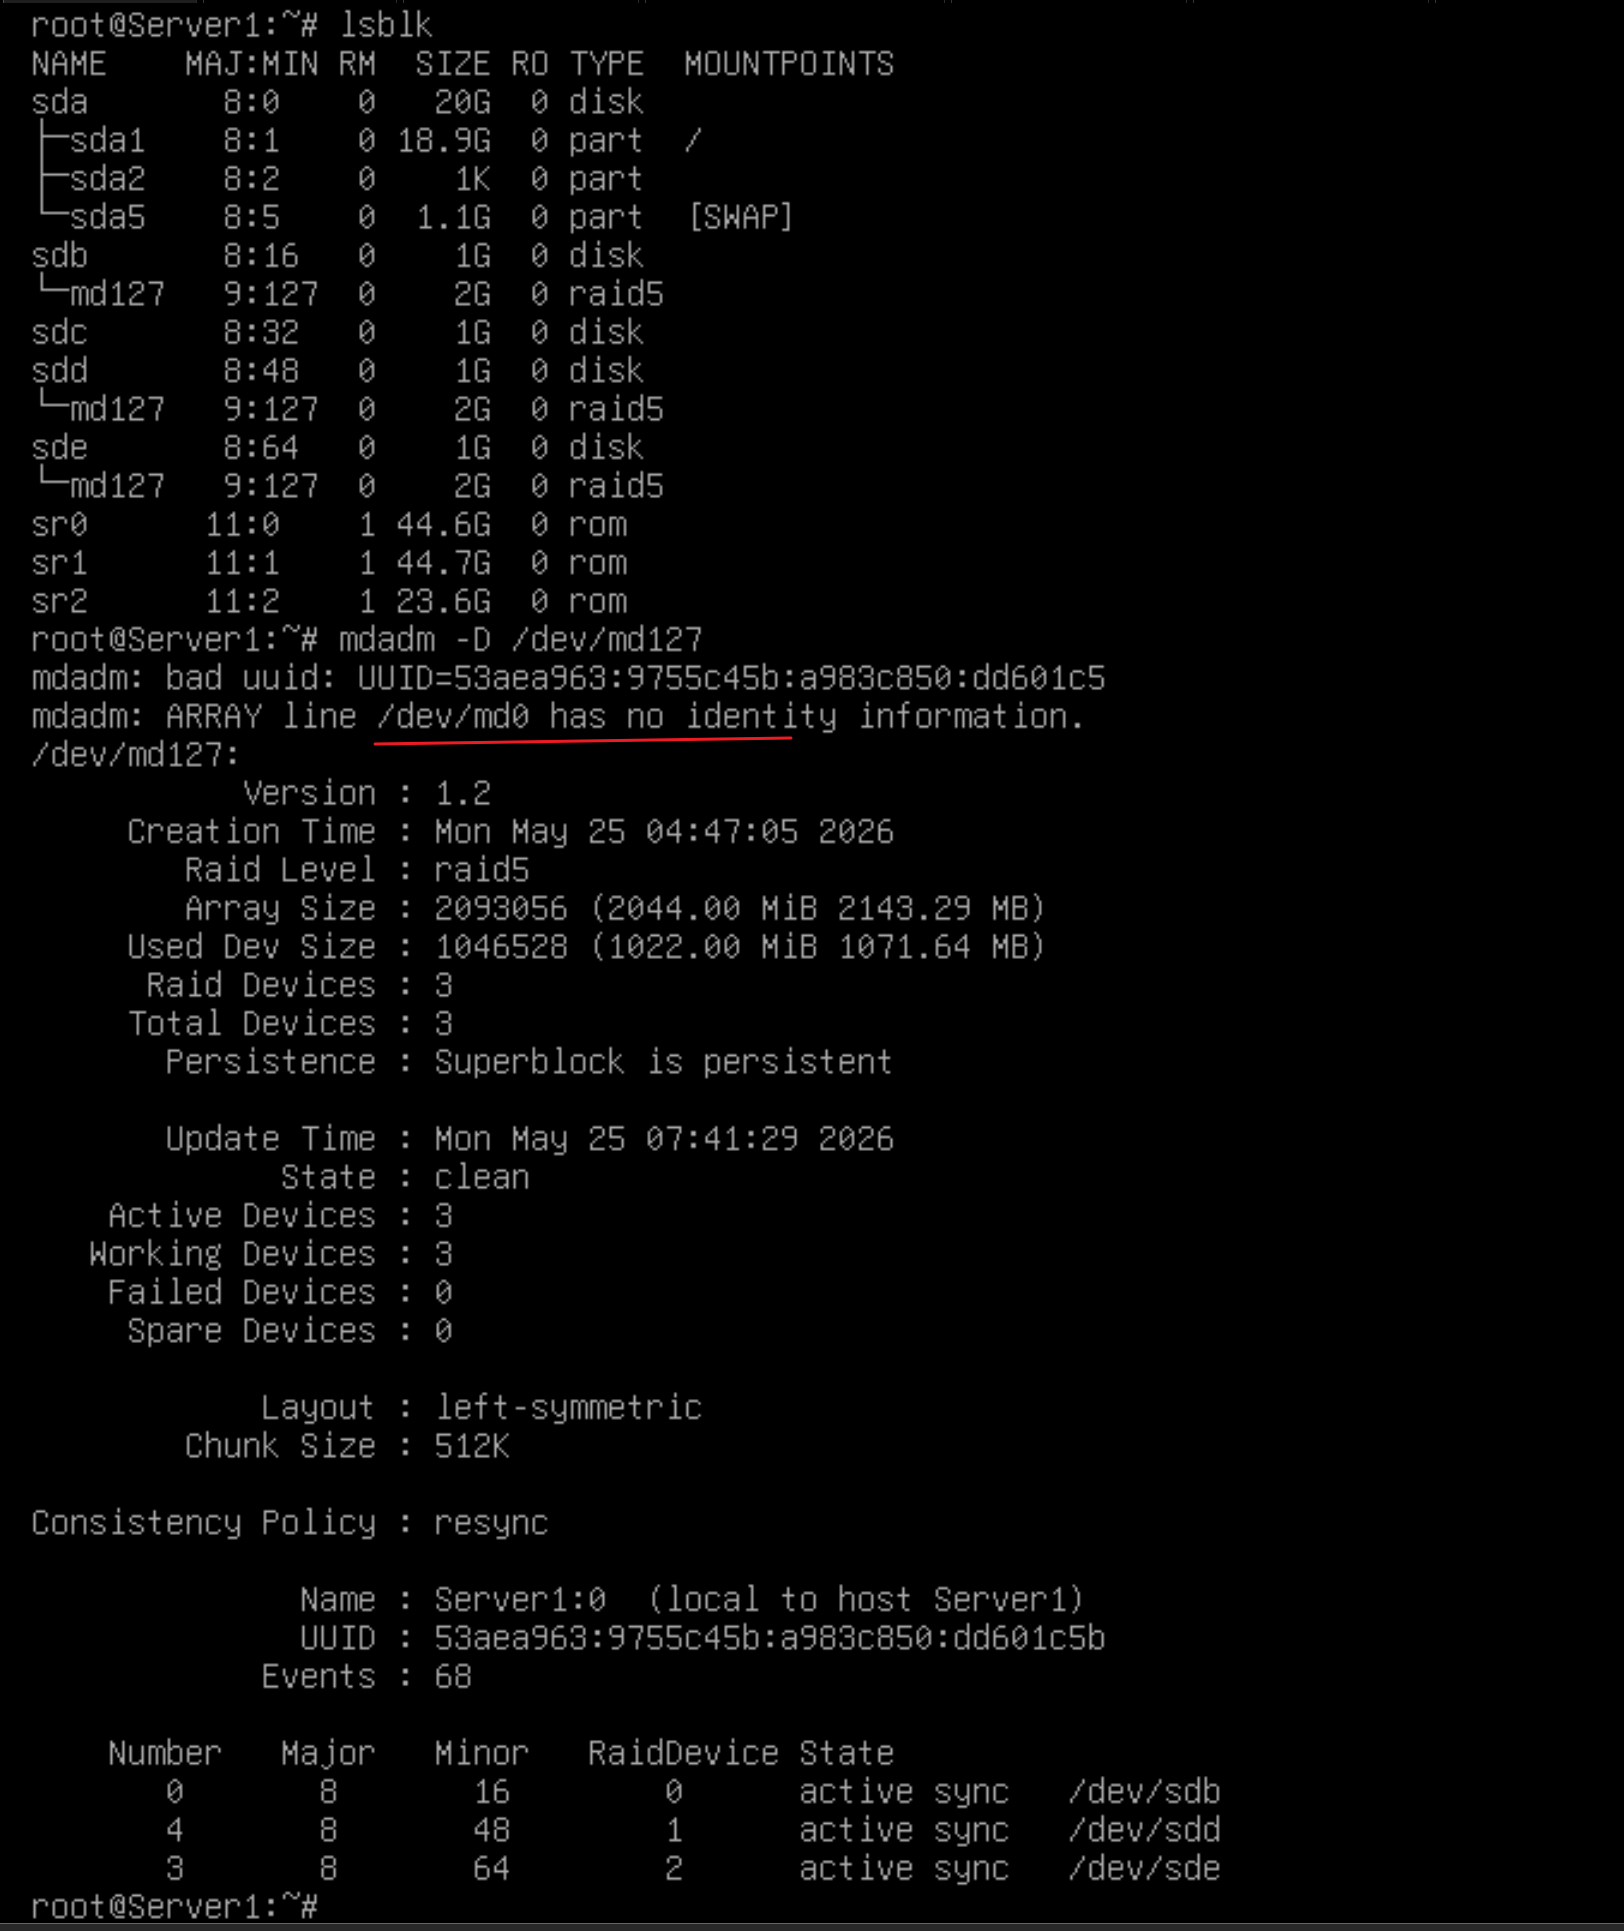
# 查看 /etc/mdadm/mdadm.conf 文件
看是没有写 RAID阵列的UUID,还是UUID写错,根据错误来编写ticket
·编写 ticket:
# 排查过程:
On Server1:
Execute the following command in the command line:
lsblk
mdadm -D /dev/md0
cat /etc/mdadm/mdadm.conf
find the array name called /dev/md0, but is shown as /dev/md127,and in the /etc/mdadm/mdadm.conf file,the array UUID is incorrect with /dev/md0

# 问题:
On Server1:
in the /etc/mdadm/mdadm.conf file,the array UUID is incorrect with /dev/md0

# 解决方法:
On Server1:
modify the /etc/mdadm/mdadm.conf file, replace the UUID:
UUID=53aea963:9755c45b:a983c850:dd601c5b
and update the initramfs:
update-initramfs -u
and reboot Server1 device
(还有一种情况)也是一样的症状,但是 /etc/mdadm/mdadm.conf 文件中写了 UUID,并且UUID也没写错,但 /dev/md0 还是显示为 /dev/md127,这是因为写了 /etc/mdadm/mdadm.conf 文件后,没有执行 update-initramfs -u 命令
这个比较难排查,基本只能靠猜,然后执行一下这个命令重启看名称有没有恢复即可
4、故障环境4(阵列 inactive,不能挂载):
·设置故障点:
umount /test
mdadm --stop /dev/md0
mdadm --incremental /dev/sdb
mdadm --incremental /dev/sdc
mdadm --incremental /dev/sdd
·症状:
读取不了 /dev/md0 磁盘,无法进行挂载·进行排查:
mdadm -D /dev/md0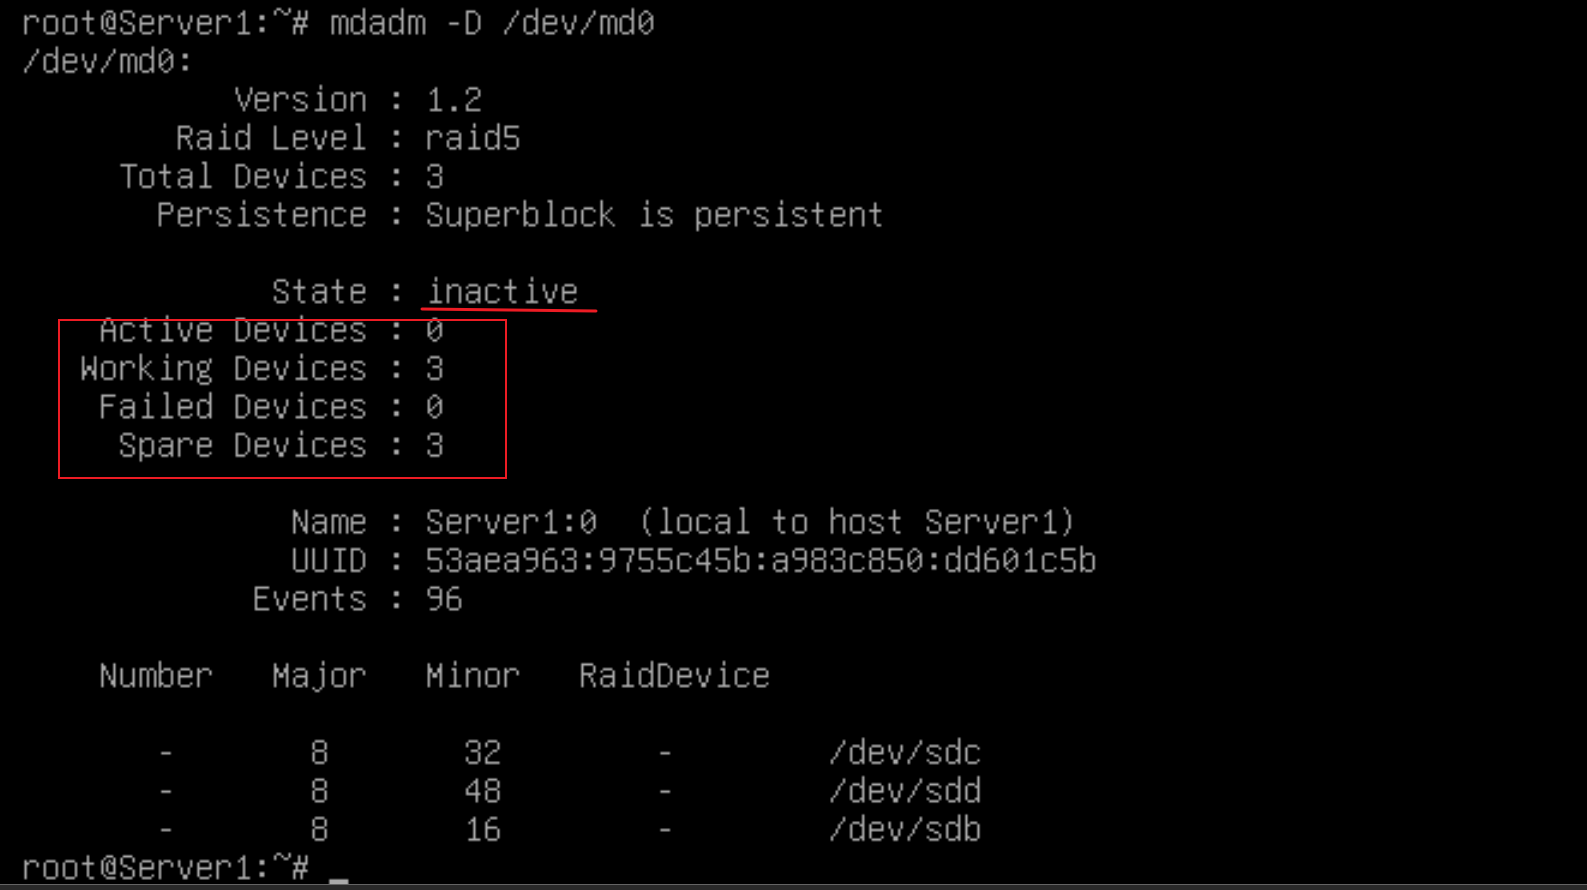
cat /proc/mdstat状态为 inactive
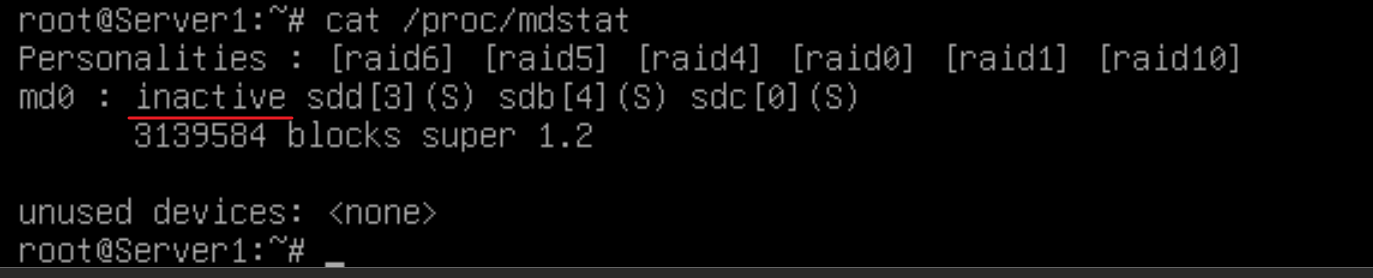
·编写ticket:
# 排查过程:
On Server1:
Execute the following command in the command line:
cat /proc/mdstat
mdadm -D /dev/md0
find the /dev/md0 array is inactive

# 问题:
On Server1:
The /dev/md0 array is inactive

# 解决方法:
On Server1:
Execute the following command in the command line:
lsblk    //记住mdadm成员磁盘,需要用那几块磁盘重组
mdadm --stop /dev/md0
mdadm --asemble --run /dev/md0 /dev/sd[cde]
systemctl daemon-reload
mount -a
mdadm -Ds >> /etc/mdadm/mdadm.conf
update-initramfs -u
and reboot Server1 device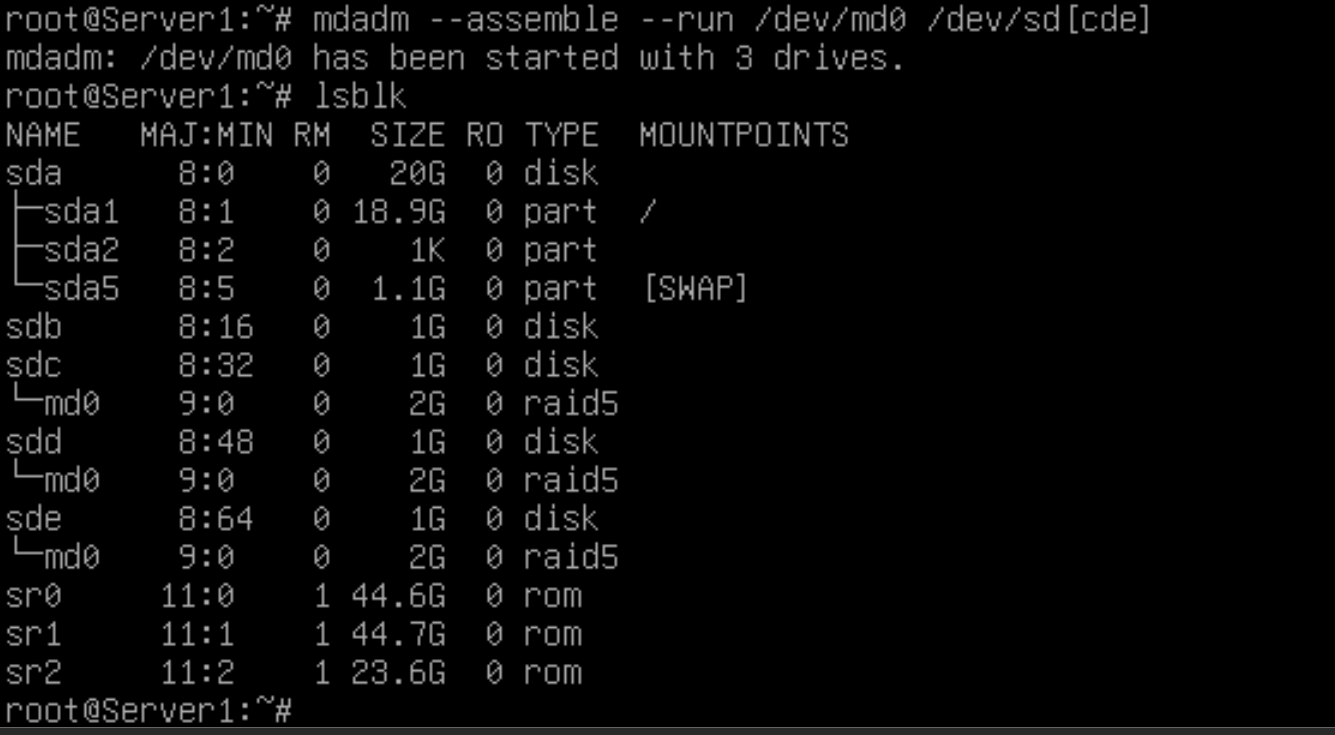
5、故障环境5(文件系统挂载失败):
·设置故障点(破坏ext4 主 superblock):
umount /test
dd if=/dev/zero of=/dev/md0 bs=1024 count=2 conv=notrunc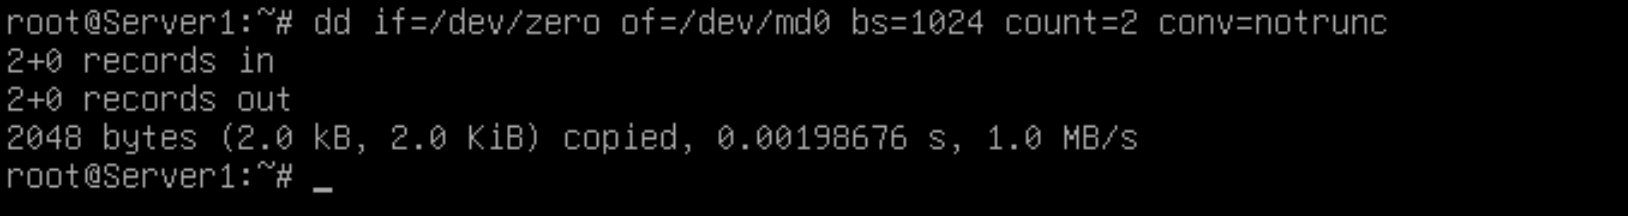
·症状:
提示错误的类型
·进行排查:
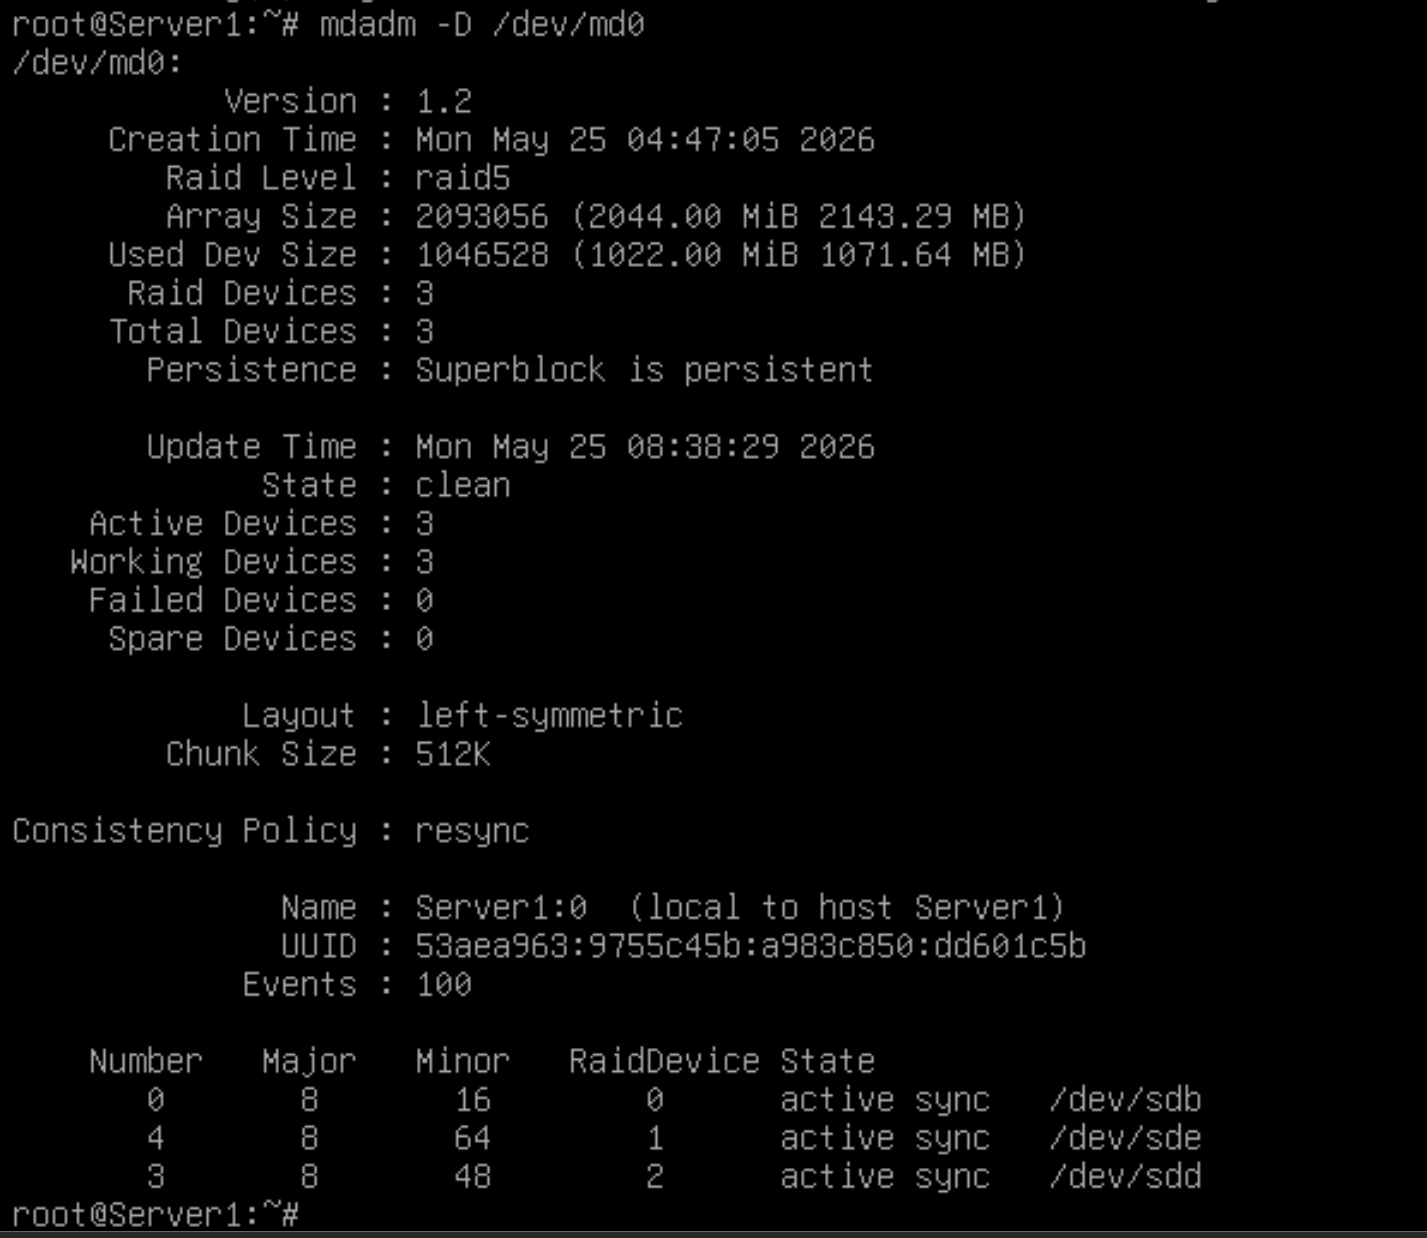
# 查看 /proc/mdstat 的 /dev/md0 都是没问题的:
cat /proc/mdstat
mdadm -D /dev/md0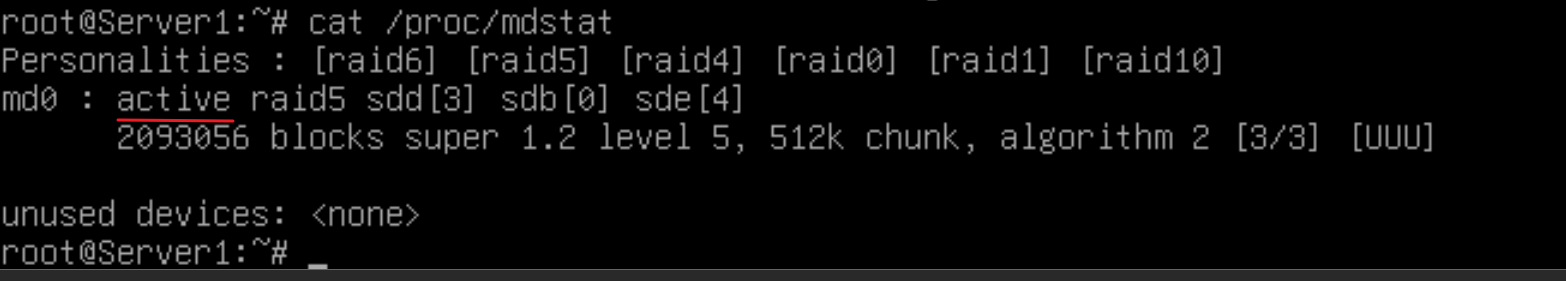
# 检查文件系统:
blkid /dev/md0
file -s /dev/md0    //file命令需要安装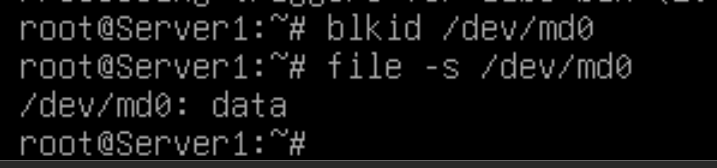
可以看到 blkid 查看不到 /dev/md0 有任何文件格式
·修复:
文件系统损坏是非常危险的,很容易数据丢失,只能从 磁盘备份块中恢复数据
mke2fs -n /dev/md0 //加 -n 只是查看,而非格式化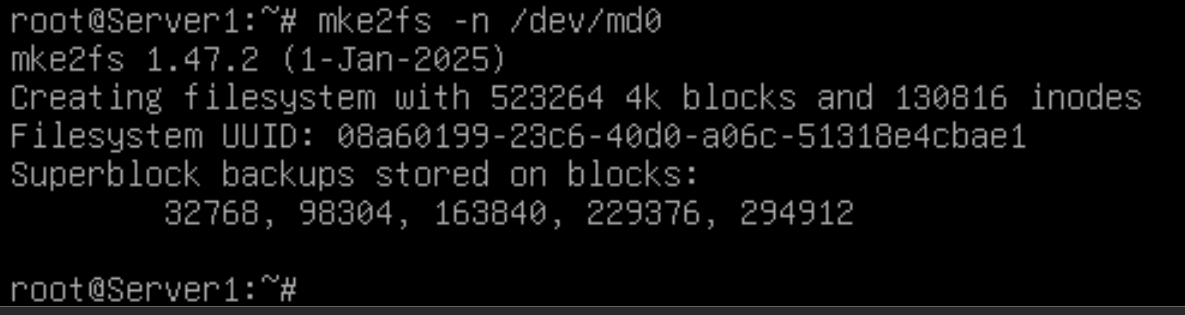
这里备份数据存储的块,我们从这些块进行恢复
# 先从小的开始:
e2fsck -f -b 32768 /dev/md0
# 如果 32768不行,报错时,就换下一个:
e2fsck -f -b 98304 /dev/md0
只要能够弹出这个,就是修复成功了:
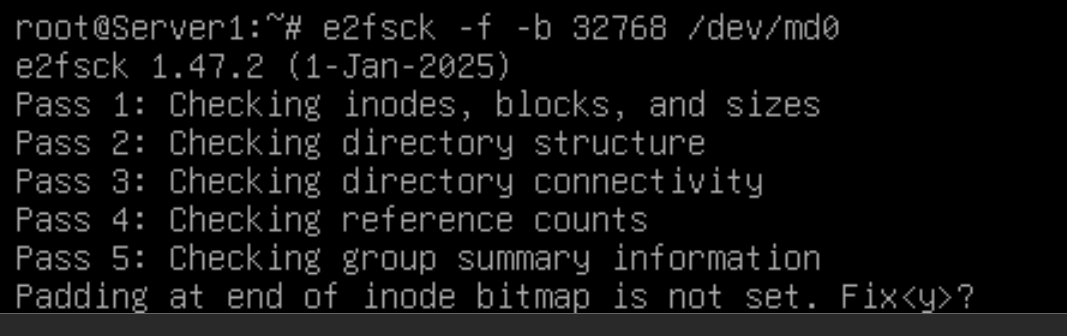
按y确定
此时再用 blkid 就能够显示出它的格式:
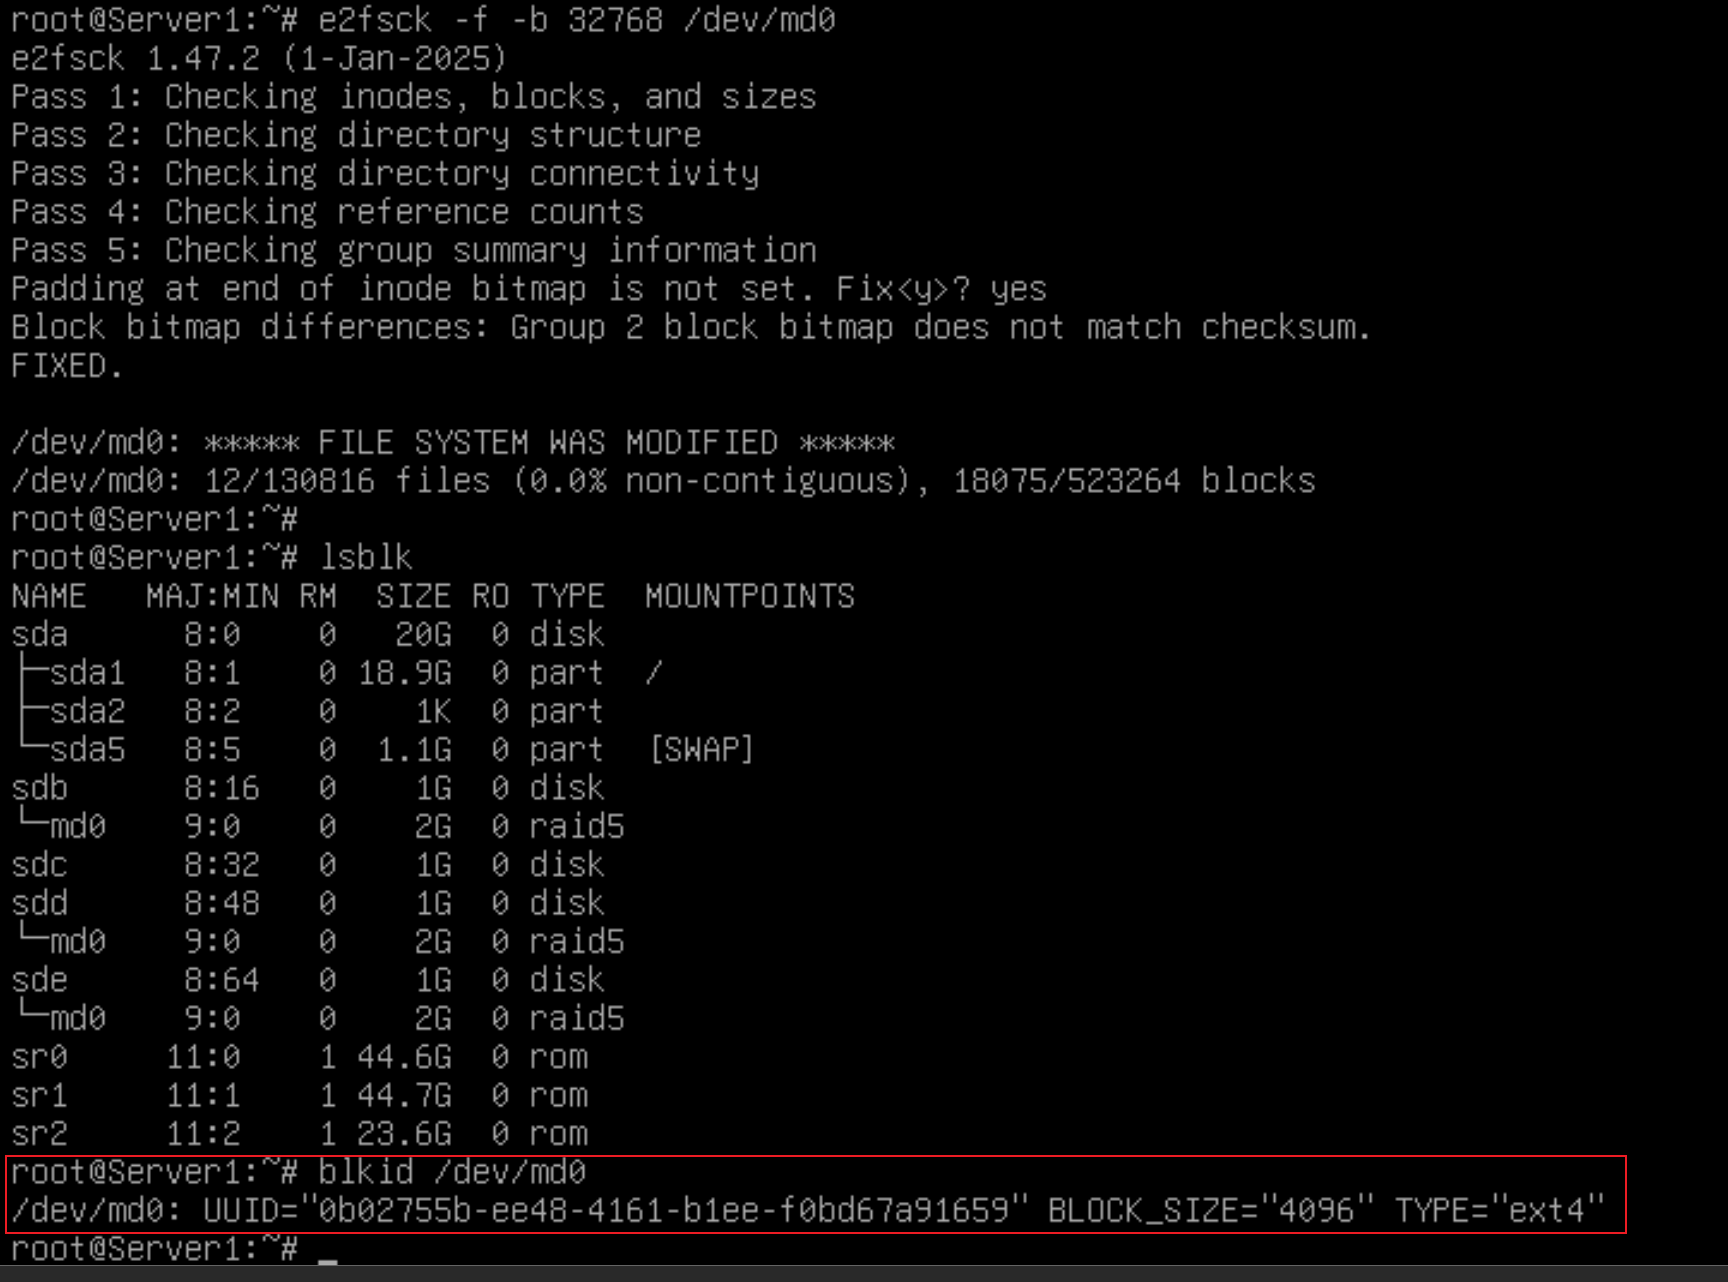
·编写 ticket:
# 排查过程:
On Server1:
Execute the following command in the command line:
cat /proc/mdstat
mdadm -D /dev/md0
blkid /dev/md0
The blkid command cannot catch any file system format for /dev/md0

# 问题:
On Server1:
the /dev/md0 array file system is destroy

# 解决方案:
On Server1:
Execute the following command in the command line:
e2fsck -f -b 32768 /dev/md0
systemctl daemon-reload
mount -a